Исторически — примерно до середины 2000-х годов — информационные системы проектировали преимущественно по методологии Waterfall. Этот подход предполагал строго последовательное движение по этапам: от глубокого проектирования архитектуры и составления документации до написания кода и тестирования. Каскадный процесс напоминал эпоху классицизма в искусстве, где отход от строгих канонов считался недопустимым.
В эпоху физической дистрибуции ошибки в софте приводили к катастрофе: ПО распространялось на CD-дисках, и выпустить патч у клиента было долго, дорого, а часто и физически невозможно. Любые изменения обходились колоссальными издержками. С другой стороны, у такой консервативности было важнейшее преимущество: система получала целостный, продуманный и монументальный инженерный фундамент ещё до написания первой строчки кода.
Однако с бурным развитием IT-индустрии каскадный подход уже не мог обеспечить скорость и гибкость, которых требовал рынок. Продукт мог проектироваться годами, а к моменту релиза оказывался морально устаревшим или ненужным заказчику.
Ответом на этот вызов стали идеи Agile. В 2001 году 17 ведущих инженеров того времени (среди которых были Кент Бек, Мартин Фаулер и Роберт Мартин) сформулировали манифест гибкой разработки. Одно из решающих влияний на формирование Agile оказало Экстремальное программирование (XP) Кента Бека — набор строгих инженерных практик: TDD, парное программирование, непрерывная интеграция и постоянный рефакторинг. Суть сводилась к гибкой адаптации: делать продукт короткими итерациями, быстро собирать обратную связь от рынка и не бояться менять код на лету.
Но в своей первоначальной концепции такой подход требовал от инженеров высочайшей квалификации и бескомпромиссной дисциплины.
«Ходячий скелет» (Walking Skeleton): инженерное ядро гибких архитектур
Когда Agile стал массовым мейнстримом, из него во многом выродилось первоначальное инженерное ядро: XP-практики, TDD и архитектурная гигиена. В массовой практике остались лишь внешние ритуалы (стендапы, ретроспективы и спринты), а саму гибкость бизнес нередко превратил в инструмент микроменеджмента и хаотичной нарезки разрозненных бизнес-функций.
Я часто видел, как слепое следование процессам приводило команды к созданию «франкенштейн-архитектур». Когда базовые системные решения не закладываются осознанно, а «выращиваются на ходу» от спринта к спринту, система быстро тонет под грузом технического долга. Очередная бизнес-функция ломает зыбкий фундамент, который никто изначально не проектировал под реальные нагрузки.
Однако внутри Agile существует мощный архитектурный паттерн — «Ходячий скелет» (Walking Skeleton). Этот термин ввёл Алистер Коберн (Alistair Cockburn), один из соавторов Agile-манифеста; подробно он описан в его работах по семейству методологий Crystal (в частности, Crystal Clear, 2004). В эпоху монолитных серверных приложений метод оставался скорее красивой метафорой, но в мире распределённых систем и Edge-вычислений он стал базовой инженерной необходимостью.
В своей сути Ходячий скелет выступает идеальным мостом, который соединяет два мира: продуманный инженерный фундамент от классического проектирования и итеративную гибкость от Agile.
Для реализации Edge-first систем Walking Skeleton — это база, с которой необходимо начинать. Мы стартуем не с бизнес-логики (детекции лиц, захвата видеопотока или красивого UI), а с построения минимального, но сквозного и жизнеспособного каркаса.
Чем скелет не является
Чтобы избежать терминологической путаницы, проведём чёткую границу:
| Артефакт | Суть | Проблема в контексте Edge |
|---|---|---|
| PoC (Proof of Concept) | Доказывает, что технология работает в принципе. | Запускается на ноутбуке в стерильных условиях. Не отвечает на вопрос: «Что произойдёт при −20 °C, просадке питания и обрыве LTE?». |
| Прототип / Mock | Имитирует поведение для демо инвесторам или клиентам. | Фейковые данные, заглушки вместо реального железа. Создаёт опасную иллюзию готового продукта. |
| MVP (Minimum Viable Product) | Минимальный набор пользовательских функций. | Фокусируется на клиентской ценности, но часто игнорирует системную обвязку. В Edge это прямой путь к превращению устройства в «кирпич» при первом же боевом OTA-обновлении. |
Ходячий скелет — это не прототип и не мок. Это предельно тонкий, но полностью рабочий сквозной архитектурный каркас (End-to-End). Он ещё не несёт прямой бизнес-ценности конечному пользователю, но обладает концептуальной цельностью: каждый системный слой — от инициализации железа и работы с энергонезависимой памятью до защищённого канала связи с облаком — уже скомпонован, запущен и проверен на устойчивость к сбоям.
Почему Feature-First ломается на периферии: антипаттерн «Начнём с нейросети»
Главное следствие отказа от «Ходячего скелета» — падение в ловушку Feature-First разработки, когда продукт создаётся «от фичи», а не от фундамента.
Типичный сценарий из практики Edge-видеонаблюдения: команда с сильным ML-бэкграундом начинает разработку с самого эффектного слоя — с нейросети. Инженеры месяцами полируют пайплайн детекции: оптимизируют квантование весов, добиваются 98.5% mAP (цифра иллюстративная) на эталонном датасете и рисуют аккуратные bounding boxes на демо-стенде в офисе.
Но как только устройство монтируется на реальном объекте, система сталкивается с физической реальностью:
- При внезапном отключении питания локальная база данных повреждается в момент незавершённой транзакции, и нода уходит в бесконечный bootloop.
- LTE-модем теряет регистрацию в сети из-за интерференции, а код не умеет восстанавливать TLS-сессию с экспоненциальным backoff’ом, поскольку в офисе всё работало через стабильный гигабитный Ethernet.
- Диск переполняется за трое суток, потому что ротацию логов, кадровых буферов и политику вытеснения отложили «на фазу стабилизации перед релизом».
Нейросеть при этом математически безупречна, но практическая ценность устройства равна нулю: нода нестабильна как программно-аппаратный комплекс.
В распределённых автономных системах прикладная бизнес-логика вторична по сложности. Первична — стабильность автомата состояний, детерминизм работы с ресурсами и надёжность инфраструктурной обвязки.
Если наш Ходячий скелет способен пережить внезапное обесточивание, аппаратный сбой модема, отказ сенсора камеры и критическое заполнение диска, не потеряв консистентность состояния, — мы можем уверенно и безопасно наращивать прикладную функциональность.
Пять новых парадигм
Чтобы «Ходячий скелет» выжил в физическом мире — в условиях аварийных отключений питания, нестабильной связи, аппаратных сбоев и жестких лимитов по ресурсам и теплу, — архитектура должна опираться на пять фундаментальных смен парадигмы, произошедших в индустрии за последние два десятилетия:
- Security (Гарантия целостности среды): Сдвиг от защиты сетевого периметра к Zero-Trust и криптографической верификации. Парадигма дает софту способность не доверять окружению по умолчанию. Это позволяет гарантировать подлинность каждого байта системы (
Secure Boot→dm-verity), делая ноду устойчивой к физическому перехвату и подмене софта злоумышленником вне охраняемого дата-центра. - Reliability (Адаптивная отказоустойчивость): Сдвиг от иллюзии достижения абсолютной аптайм-надёжности к Resilience Engineering. Парадигма дает системе способность динамически адаптироваться к авариям вместо попыток их предотвратить. Именно это позволяет софту выживать при внезапных отключениях питания и интермиттирующей (периодически пропадающей) связи через архитектуру
Crash-Onlyи паттерны деградации. - Efficiency (Вычислительный детерминизм): Сдвиг от иллюзии «быстрое железо компенсирует неэффективный код» к сочувствию к памяти через Mechanical Sympathy и Data-Oriented Design. Парадигма дает предсказуемый
Tail Latency (p99.9)кадра и защиту отOOM-killer. Проектирование от плоских структур данных (SoA) гарантирует, что приложение уложится в жесткие лимиты памяти, а процессор не будет простаивать в ожидании DRAM. - Integration (Аппаратная синергия софта и кремния): Сдвиг от изоляции софтверных слоёв к глубокой совместимости через Hardware-Software Co-Design. Парадигма обеспечивает максимальный FPS на ватт за счет подгонки математики алгоритмов (
INT8 Quantizationв OpenVINO/ORT) и конвейеров памяти (Zero-copy / DMA-BUF) под топологию конкретного чипа. Это позволяет утилизировать специализированные ускорители на 100% без превышения теплопакета (TDP) ноды. - Observability (Диагностическая прозрачность): Сдвиг от пассивного мониторинга («работает/сломалось») к сквозной Наблюдаемости (OpenTelemetry). Парадигма дает возможность понимать причины нелинейных скрытых сбоев распределенной системы на основе анализа связанных логов, метрик и распределенных трейсов, не создавая при этом избыточной нагрузки на горячем пути видеоконвейера.
Понимание этих сдвигов определяет инженерные решения для каждого компонента нашей Edge-ноды.
1. От защиты периметра к Zero-Trust и Privacy-First
Исторически безопасность корпоративных систем строилась по модели «замка и рва» (Castle-and-Moat): защищался исключительно внешний периметр (файрволы, DMZ, VPN), а всё, что находилось внутри локальной сети, априори считалось доверенным.
Эту модель серьёзно подорвали сложные таргетированные атаки конца 2000-х — начала 2010-х. Она не исчезла (периметр остаётся одним из слоёв защиты), но перестала считаться достаточной. Переломной точкой стала атака Operation Aurora (2009) на инфраструктуру Google и ряда технологических гигантов. Злоумышленники провели целевой фишинг сотрудников и воспользовались 0-day-уязвимостью в браузере, после чего получили возможность свободно перемещаться горизонтально (lateral movement) внутри «доверенной» корпоративной сети.
Ответом Google стала инициатива BeyondCorp (2014) — одна из первых крупных промышленных реализаций идей Zero-Trust, термин для которых ввёл аналитик Forrester Джон Киндервааг (John Kindervag, 2010). Формализован подход заметно позже — в NIST SP 800-207 (2020).
Базовый постулат Zero-Trust: «Never trust, always verify» (Никому не доверяй, всегда проверяй). Концепция требует полного отказа от привилегированных зон и выстраивания эшелонированной обороны (Defense in Depth):
- На уровне данных: Row-Level Security (RLS) и криптографическая изоляция, не доверяющие даже коду бэкенда.
- На уровне сервисов: взаимная сквозная авторизация каждого межпроцессного вызова.
- На сетевом уровне: признание любой сети (включая локальную LAN) изначально враждебной средой.
Важно: Zero-Trust — это не «закрытые порты и mTLS» сами по себе, а принцип явной аутентификации и авторизации каждого запроса независимо от сетевого расположения. Закрытые порты, mTLS и аппаратная идентичность устройства — лишь его конкретные реализации на Edge-ноде.
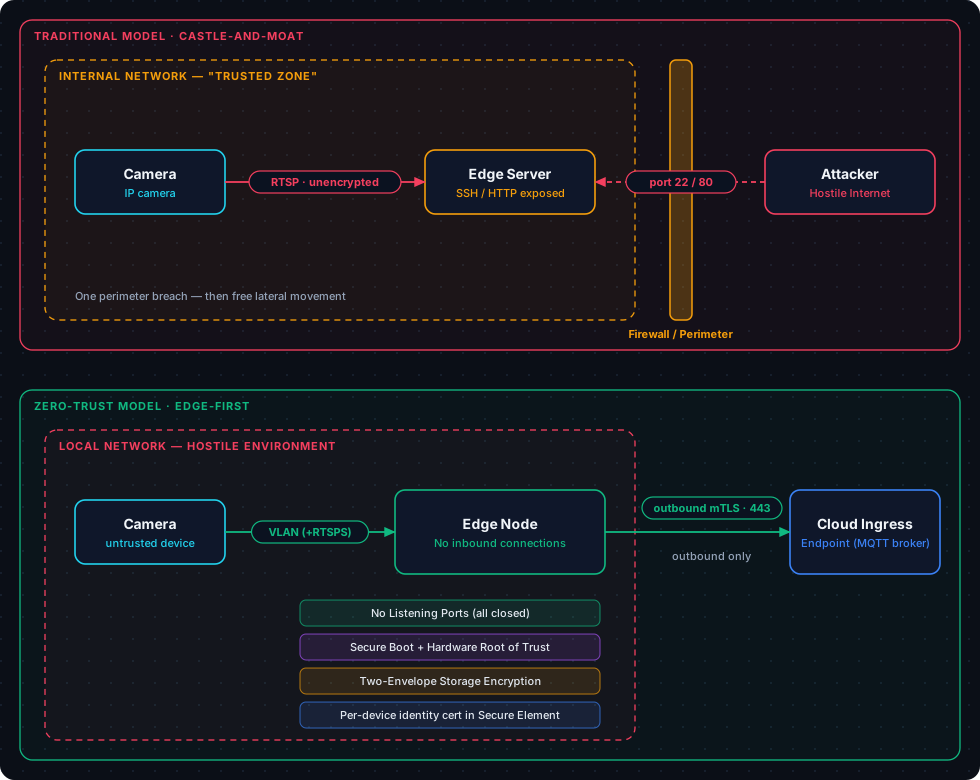
Применение Zero-Trust к проектированию Edge-first
Edge-нода физически располагается на объекте заказчика: в щитовой на складе, на столбе или в открытом серверном шкафу. Любой человек имеет к ней доступ с обычной отвёрткой. Сетевой транспорт — публичный LTE-канал или гостевая сеть предприятия. В модель угроз изначально закладываются: физическое извлечение накопителя, перехват трафика (MITM), Rogue DHCP, подмена DNS и попытки клонирования прошивки.
Отдельная проблема — сами камеры: многие IP-камеры не поддерживают RTSPS, живут с дефолтными паролями и устаревшими прошивками. Поэтому камеры выносятся в изолированный VLAN или на отдельный сетевой интерфейс ноды, а шифрование и аутентификация на этом участке включаются там, где камера это умеет (RTSPS, аутентификация ONVIF); в остальных случаях сегмент считается недоверенным и ограничивается физически и сетевыми политиками.
На основе Zero-Trust мы закладываем три архитектурных правила:
- Полный отказ от входящих соединений (No Listening Ports). Нода не слушает ни одного сетевого порта: на ней отключены демоны SSH, HTTP-серверы администрирования и открытые RTSP-эндпоинты. Вся коммуникация — это исключительно исходящие долгоживущие сессии (Outbound TCP/TLS 443) к валидированным облачным эндпоинтам. Аутентификация строится на строгом mTLS (mutual TLS) с двусторонней проверкой сертификатов. Ротация сертификатов выполняется через штатный OTA-канал: новый сертификат доставляется в зашифрованном payload’е, подписанном доверенным CA, и подхватывается при плановом reconnect’е. Для холодного старта и аварийного восстановления используется уникальная идентичность устройства: клиентский сертификат, ключ которого сгенерирован внутри Secure Element и не покидает его, а сертификат подписан производственным CA при сборке (в духе IEEE 802.1AR / DevID). Общих токенов на весь парк нет: компрометация одного устройства не затрагивает остальные.
- Аппаратный корень доверия (Hardware Root of Trust) и изоляция. Криптографические ключи и приватные сертификаты генерируются и хранятся внутри криптографического сопроцессора (Secure Element / TPM 2.0), не позволяющего извлечь приватный ключ программно. Конкретная реализация зависит от платформы: на RK3588, как правило, это дискретный Secure Element/TPM (или fTPM на базе OP-TEE), на Jetson Orin — fTPM/OP-TEE и собственная цепочка Secure Boot. Целостность софта гарантируется механизмом Secure Boot (криптографическая верификация цепочки: Bootloader → Ядро Linux → dm-verity корневой файловой системы). Насколько я знаю, на сегодняшний день это самая надежная и математически доказанная схема защиты целостности ОС (Железо доверяет только Загрузчику, Загрузчик доверяет только Ядру, а Ядро доверяет файловой системе только через криптографическое дерево dm-verity). Внутри ОС соблюдается принцип наименьших привилегий (Least Privilege): каждый компонент, работающий с недоверенным вводом или ключами, выносится в отдельный процесс под собственным uid с seccomp-профилем (см. раздел «Модель потоков»), поэтому скомпрометированный видеопроцесс (
video-pipeline, в котором работаетCameraManager) не имеет доступа ни к ключам шифрования архива, ни к базе конфигурацииNodeStore. - Privacy-First и двухконвертное шифрование (Two-Envelope Encryption). Мы исключаем доверие к локальному носителю данных. При краже SSD или выпаивании чипа памяти злоумышленник не должен получить доступ к видеозаписям. Локальный архив защищается так:
- Каждый видеосегмент шифруется уникальным симметричным ключом данных (DEK — Data Encryption Key, AES-256-GCM, уникальный nonce на сегмент).
- DEK запечатывается вложенно: сначала аппаратно-привязанным ключом ноды из Secure Element (Node KEK), затем открытым ключом конечного клиента или облачного KMS (Client KEK):
Enc_ClientKEK( Enc_NodeKEK(DEK) ). Именно вложенность задаёт логику «И»: клиент снимает внешний слой своим приватным ключом, нода — внутренний через Secure Element; без любого из двух участников DEK не получить. - Если обернуть DEK двумя независимыми обёртками (по одной на каждый ключ), получится логика «ИЛИ»: архив откроет любой из ключей. Такой вариант уместен, когда ноде нужно автономно читать собственный архив, но это другая модель угроз.
- Границы схемы. Она защищает данные at rest: от кражи накопителя и от персонала на объекте, не имеющего ключей (сквозное шифрование с ключом, который держит клиент). Термин Zero-Knowledge здесь неприменим: работающая нода знает DEK в момент записи. Компрометацию живой ноды схема не закрывает — для этого служат Secure Boot, изоляция процессов и закрытые порты. Поскольку Node KEK привязан к железу, выход из строя Secure Element делает локальный архив нечитаемым: архив — это кэш, а не единственная копия.
2. От иллюзии достижения абсолютной надежности к Resilience Engineering
Параллельно со сдвигом в безопасности происходила революция в теории надёжности. Классическая инженерная школа исходила из презумпции: цель проектирования — создать систему без дефектов через исчерпывающие спецификации и длительные циклы верификации. Отказ рассматривался как грубое нарушение технологического процесса.
Эта иллюзия была поставлена под сомнение социологом Чарльзом Перроу (Charles Perrow) в фундаментальном труде «Normal Accidents» (1984). Анализируя техногенные инциденты в критических системах (включая аварию на АЭС Три-Майл-Айленд), Перроу сформулировал Теорию нормальных аварий (Normal Accident Theory):
В системах с высокой интерактивной сложностью и жёсткой связанностью компонентов серьёзные аварии — нормальное, ожидаемое свойство самой системы, а не результат единичной ошибки оператора или отказа одной детали.
Близкие идеи позже получили практическое воплощение в IT-индустрии и в школе Resilience Engineering (Хольнагель, Вудс и др., середина 2000-х). Эрик Хольнагель, Дэвид Вудс и Сидни Деккер в середине 2000-х предложили не опускать руки, а сменить сам подход к безопасности.
- Safety-I (Старый подход): Безопасность — это отсутствие инцидентов. Нужно найти виновного, написать еще больше инструкций, закрутить гайки и сделать систему жестче.
- Safety-II (Resilience Engineering): Безопасность — это способность системы динамически адаптироваться к меняющимся условиям и продолжать работать, даже когда что-то пошло не так. Система безопасна не потому, что в ней нет сбоев, а потому, что люди и механизмы умеют справляться с неожиданностями.
Именно идеи Resilience Engineering легли в основу современного SRE (Site Reliability Engineering), DevOps-культуры и облачных архитектур:
- Проектирование под сбои (Design for Failure): Мы больше не строим «непадающие» сервера. Мы строим системы, где падение целого дата-центра (микро-катастрофа по Перроу) автоматически обрабатывается балансировщиком, а пользователи даже ничего не замечают.
- Chaos Engineering (Хаос-инженерия): Придуманный в Netflix инструмент Chaos Monkey — это прямое воплощение Resilience Engineering. Мы намеренно ломаем боевые сервера в случайное время, чтобы проверить, насколько хорошо система умеет адаптироваться к стрессу.
- Blameless Postmortems (Безвинные разборы полетов): Вместо поиска виноватого (что критиковал Сидни Деккер), IT-индустрия исследует, почему система позволила админу совершить эту ошибку и как сделать архитектуру более устойчивой к человеческому фактору.
Ключевые события движения к новой парадигме:
- Netflix (2010–2011) создал инструмент Chaos Monkey и положил начало практике Chaos Engineering, начав намеренно выводить из строя production-узлы в рабочие часы — когда инженеры на месте и могут быстро отреагировать. Философия: вместо тщетных попыток предотвратить отказ, система обязана быть спроектирована так, чтобы непрерывно деградировать и самовосстанавливаться без деградации пользовательского опыта (Graceful Degradation).
- Публикация книги Google SRE (2016) ввела в широкую практику концепт Error Budget (бюджет ошибок): инженерно-экономический аргумент в пользу того, что 100% надёжность недостижима и непропорционально дорога, поэтому допустимый уровень отказов закладывается явно.
- AWS устами CTO Вернера Фогельса (Werner Vogels) закрепил фундаментальное правило современных распределённых систем: «Everything fails all the time» (Всё ломается постоянно).
3. Сдвиг от иллюзии «быстрое железо компенсируют неэффективный код» к Mechanical Sympathy и Data-Oriented Design
Третий сдвиг произошёл на стыке архитектуры софта и физических ограничений кремния.
До середины 2000-х годов софтверная разработка развивалась в рамках концепции «бесплатного обеда» (Free Lunch): производительность одного потока процессора росла экспоненциально (закон Мура — примерно удвоение каждые 18–24 месяца) во многом благодаря росту тактовых частот и микроархитектурным улучшениям. Неэффективность абстракций и глубоких иерархий классов в ООП нивелировалась мощью следующего поколения CPU.
Эта парадигма разрушилась под действием двух физических барьеров:
- Memory Wall (Стена памяти). Ещё в 1995 году Уильям Вульф и Салли Макки в работе «Hitting the Memory Wall» показали (экстраполируя тренды), что разрыв между экспоненциально растущей скоростью вычислений процессора и медленным ростом пропускной способности оперативной памяти приведет к тому, что процессор будет проводить подавляющую часть времени в простоях (CPU Stalls), ожидая загрузки данных из DRAM.
- Конец масштабирования Деннарда (Dennard Scaling). К 2005 году физика полупроводников упёрлась в тепловой барьер: дальнейший рост тактовых частот приводил к критическому току утечки и лавинообразному энергопотреблению чипов. Герб Саттер (Herb Sutter) зафиксировал этот перелом в программной статье «The Free Lunch Is Over» (2005): бесплатный прирост производительности закончился, а вычисления стали параллельными и гетерогенными.
Иерархия памяти и цена доступа к данным (если 1 такт ≈ 1 секунда):
| Уровень памяти | Задержка | Масштаб «в человеческом времени» |
|---|---|---|
| Регистры CPU | ~0.5 нс | 1 секунда |
| Кэш L1 | ~1–1.5 нс | 3 секунды |
| Кэш L2 | ~3–4 нс | 8 секунд |
| Кэш L3 | ~15–20 нс | 40 секунд |
| DRAM (LPDDR4x/DDR5) | ~60–100 нс | 2–3 минуты (CPU простаивает) |
| NVMe / eMMC | ~10–100 мкс | От нескольких часов до дней |
Современный процессор выполняет инструкции в регистрах за доли пикоджоулей энергии, тогда как операция вытягивания 64 байт (Cache Line) из внешней DRAM требует на три–четыре порядка больше энергии, чем целочисленное сложение, и сотен тактов простоя (Mark Horowitz, ISSCC 2014). Марк продемонстрировал в своем докладе на ISSCC 2014, что физическое перемещение электронов по длинным медным дорожкам материнской платы от DRAM к процессору сжигает колоссальное количество энергии по сравнению со сдвигом зарядов внутри крошечного кристалла самого процессора. Процессор больше не вычисляет постоянно — он подолгу ждёт доставку данных.
Ответом индустрии стала парадигма Mechanical Sympathy («механическое сочувствие» к железу) — термин, который Мартин Томпсон (Martin Thompson) заимствовал у автогонщика Джеки Стюарта и популяризировал при разработке ультранизколатентной системы LMAX Disruptor (2011). Практической дисциплиной этой концепции стал Data-Oriented Design (DOD), сформулированный в своем знаменитом докладе Майком Эктоном в 2014 году (Mike Acton, CppCon 2014). По существу, мы должны смотреть на программу как на трансформацию данных из одного представления в другое на конкретном физическом оборудовании. Если мы не понимаем, как данные приложения раскладываются в памяти, как процессор загружает эти данные в свою пирамиду кэшей, мы не сможем писать высокопроизводительный код. Процессор будет постоянно простаивать.
Если сводить суть концепции к прикладному уровню:
Программирование — это не управление абстрактными объектами, а трансформация данных. Архитектура программного обеспечения должна строиться не вокруг ментальных моделей человека (как в ООП), а вокруг того, как данные физически лежат в памяти и как их читает процессор.
Разработчик обязан понимать аппаратную реальность: кэш-линии (Cache Lines), задержки DRAM, работу предсказателя переходов (Branch Predictor). Написание кода без оглядки на железо — это создание неэффективных программ по определению. Например, в ООП мы мыслим категориями «Сущность имеет свойства» (например, у каждого врага в игре есть координаты, здоровье, имя, текстура, и все это лежит в одной куче в памяти). В Data-Oriented Design мы смотрим на данные как на потоки. Если нам нужно обновить координаты 10 000 объектов, нам не нужны их имена и текстуры в кэше процессора. Нам нужен плотный, непрерывный массив, состоящий только из координат — то есть переход от традиционного Array of Structures (AoS) к паттерну Structure of Arrays (SoA).
Мы обязательно должны взять на вооружение эти знания при создании Edge-first видеосистем, где нагрузка на ресурсы колоссальна.
Применение Mechanical Sympathy к Edge-first системам
Облачный сервис при росте нагрузки динамически масштабируется горизонтально. Edge-нода на базе компактного SoC (например, Rockchip RK3588, NVIDIA Jetson Orin или NXP i.MX8), установленная в герметичном боксе без активного охлаждения, жестко ограничена:
- Unified Memory & TDP Throttling: CPU, NPU (нейроускоритель), VPU (аппаратный видеодекодер) и GPU находятся на одном кристалле и делят общую шину памяти LPDDR и общий теплопакет (TDP). Если управляющий код на CPU хаотично аллоцирует память, бегает по графам объектов и провоцирует постоянные промахи L3-кэша, он перегружает общий контроллер памяти и вызывает нагрев чипа. В результате срабатывает динамический троттлинг частот (DVFS), NPU замедляется, и система начинает пропускать видеокадры.
- Детерминизм против пиковых задержек (Tail Latency): В Edge-видеоаналитике целевая метрика — не усреднённый FPS, а соблюдение бюджета на кадр на уровне p99.9 (33.3 мс для потока 30 кадров/с). Непредсказуемая пауза — блокировка мьютекса, аллокация, фрагментация кучи, вытеснение планировщиком — приводит к потере детекции критического события. Оговорка: ни Linux, ни tokio не дают жёстких гарантий реального времени (в Rust нет сборщика мусора, но это не делает рантайм real-time). Поэтому p99.9 для нас — целевая метрика, которую мы измеряем под нагрузкой и при деградации, а не контрактная гарантия.
Отсюда следуют три архитектурных инварианта:
- Bounded by Design (Жёстко ограниченные ресурсы). Ни одна внутренняя очередь, ring-буфер или кэш-таблица не имеют права динамически расти без ограничений. Память под кадровые пулы и кольцевые буферы событий выделяется единожды при инициализации процесса (Static Allocation / Bounded Pools). Локальное дисковое хранилище — это строго лимитированная структура с прозрачной кольцевой ротацией: свободное место на диске не упадёт до нуля, так как объём данных на ноде ограничен проектной константой. Это прагматичная версия правила №3 стандарта NASA/JPL Power of Ten («после завершения инициализации динамическая память не выделяется»). В Rust-проекте с tokio, TLS и встраиваемой БД буквально выполнить его невозможно, поэтому мы применяем его к горячему пути видео и к очередям, а аллокации в остальных частях ограничиваем и мониторим.
- Zero-copy конвейер передачи видеоданных. Несжатый 4K-кадр в формате NV12 весит ~12 МБ. Копирование одного такого кадра по значению при 30 fps создаёт внутрисистемный паразитный трафик около 360 МБ/с; для 8 потоков 1080p эта цифра составляет около 750 МБ/с (1920×1080×1,5 ≈ 3,1 МБ на кадр) — и это только один проход копирования, а чтение плюс запись удваивают нагрузку на шину. На компактном SoC это съедает пропускную способность памяти, необходимую NPU для выборки весов моделей. Поэтому декодированный кадр передаётся только в виде дескриптора (dmabuf): внутри
video-pipelineэто обычная передача владения хэндлом буфера междуCameraManagerиInferenceManager, без копирования и без IPC. VPU пишет кадр в буфер, масштабирование и конвертацию формата для NPU выполняет аппаратный блок (например, RGA на Rockchip), NPU читает буфер напрямую. Архивная ветка при этом вообще не требует декодирования:CameraManagerберёт исходные сжатые H.264/H.265-пакеты и ремуксит их в 10-секундные MP4-сегменты — ни декодера, ни энкодера здесь нет. Готовый сегмент уходит вvaultкак непрозрачный блок байтов черезmemfd(дескриптор поSCM_RIGHTS), без прогона содержимого через сокет. Честная оговорка: «ноль копий» — это идеал; на конкретных SoC и версиях драйверов часть форматов приходится конвертировать, и это выявляется профилированием. - Плоское состояние и модель Crash-Only Software. Состояние системы (активные камеры, конфигурация зон аналитики, локальные правила, метаданные треков) хранится не в виде сложного графа объектов в куче (Heap) с перекрёстными ссылками, а в виде плоских непрерывных структур данных (SoA/Flat Tables) с доступом по прямым индексам. Это исключает циклические ссылки, ускоряет линейный проход по кэш-линиям процессора и обеспечивает мгновенное создание снапшотов. Любой сбойный менеджер может быть в любой момент принудительно убит и перезапущен (systemd или
NodeSupervisor): плоское состояние тривиально восстанавливается из локальной БД. Для лёгких компонентов перезапуск занимает миллисекунды, для процессов с NPU/VPU — сотни миллисекунд и секунды (повторная инициализация драйверов и аппаратного контекста), и это закладывается в бюджет деградации. Это реализация концепции Crash-Only Software (Candea & Fox, Stanford): система не тратит ресурсы на сложный graceful shutdown при фатальных ошибках, её штатный механизм восстановления — быстрый детерминированный рестарт.
Мы не должны заниматься преждевременной микрооптимизацией на старте проекта. Ручная векторизация через SIMD, ассемблерные вставки и разворачивание циклов — это обратимые оптимизации, им не место в первом каркасе. Но модель владения памятью, границы очередей, zero-copy контракты и раскладка состояния — это фундаментальные необратимые решения. Их невозможно безболезненно переписать потом, когда весь код уже завязан на бесконтрольное копирование структур.
4. Сдвиг от изоляции слоёв к сквозной совместимости (Hardware-Software Co-Design)
Четвёртый тектонический сдвиг произошёл на границе раздела между чистой софтверной архитектурой и физической топологией кремния.
Десятилетиями классическая инженерная школа возводила вокруг разработчика защитные стены абстракций. Нас учили: «Хороший софт полностью изолирован от аппаратной платформы. Архитектура должна быть чистой, а особенности железа спрячут операционная система, виртуальная машина и драйверы». Эта иллюзия отлично кормила индустрию, пока производительность универсальных ядер CPU росла за счёт уменьшения техпроцесса.
Но когда масштабирование Деннарда (2005 год) заставило инженеров упереться в тепловой барьер (Power Wall), кремниевая индустрия пошла по единственному оставшемуся пути — глубокой специализации вычислителей. Современный энергоэффективный процессор больше не является «просто универсальным CPU». Это гетерогенный конгломерат, где большая часть площади кристалла отдана под специализированные сопроцессоры. Даже в x86-архитектуре Intel современный чип — это сложная система, сочетающая производительные (P-cores) и энергоэффективные (E-cores) ядра, встроенную графику (Iris Xe / Arc GPU), встроенный NPU и специализированные векторные блоки для матричных вычислений.
Попытка запустить на таком железе «абстрактный софт», написанный без оглядки на физическую структуру чипа, приводит к катастрофе: приложение задействует лишь малую часть кремния, оставляя специализированные ускорители простаивать, но при этом сжигая TDP на паразитное перетаскивание данных между слоями.
Ответом на этот кризис стала парадигма Hardware-Software Co-Design (Совместное проектирование железа и софта). Архитектура современного высокопроизводительного приложения больше не может быть независимой — она обязана стать прямым программным отражением топологии конкретного процессора.
Истоки концепции и индустриальный контекст:
Сам термин зародился еще в 1990-х годах в академической среде (в работах исследователей Стэнфорда и Принстона, таких как Джованни Де Микели и Уэйн Вольф), но тогда он применялся исключительно при проектировании специализированных микросхем (ASIC) и встраиваемых систем. В широкую практику большой IT-индустрии Co-Design ворвался в середине 2010-х годов, когда закон Мура окончательно замедлился.
Переломный момент зафиксировал Крис Латтнер (создатель компилятора LLVM, языка Swift и архитектуры MLIR), провозгласив наступление «Золотого века Hardware-Software Co-Design». На практическом уровне этот сдвиг сегодня используют главные гиганты Кремниевой долины: Apple создала свои чипы серии Apple Silicon (M1/M2/M3/M4) исключительно за счет подгонки кремния под рантайм операционной системы macOS/iOS. NVIDIA построила свою триллионную капитализацию не просто на продаже чипов, а на сквозной связке архитектуры CUDA и софтверных библиотек (тензорные ядра физически проектируются под математику современных трансформеров). Компания Google проектирует свои тензорные процессоры (TPU) в связке с разработчиками фреймворка TensorFlow/JAX.
Если сводить суть концепции к прикладному уровню:
Софт больше не пишется в изоляции от железа. Математика алгоритмов, модель владения памятью и асинхронные конвейеры приложения должны проектироваться как единое целое с физическими каналами связи, ограничениями регистров и очередями команд конкретного кремниевого кристалла.
В контексте создания Edge-first видеосистем в связке Rust + OpenVINO / ONNX Runtime на любой гетерогенной аппаратной платформе парадигма Co-Design диктует три практических правила:
- Математика алгоритмов подчиняется транзисторам (Intel VNNI/AMX). Физические регистры процессора заточены под ультрабыструю векторную арифметику. Оставлять нейросети в дефолтном формате
f32— значит греть воздух и упираться в Power Wall. Разработчик софта сознательно отказывается от абстрактной точности и с помощью инструментов OpenVINO проводит жесткое квантование (Quantization) моделей в формат INT8. Это позволяет фреймворку задействовать аппаратные инструкции Intel VNNI (Vector Neural Network Instructions) или AMX (Advanced Matrix Extensions), выполняя матричное умножение над целыми векторами данных за один такт и давая кратный выигрыш в FPS. - Модель памяти дублирует физические шины (Zero-copy + Remote Tensors). Вместо слепого выделения памяти в куче Rust, софтверный конвейер напрямую связывается с аппаратными границами чипа. Через низкоуровневый интерфейс ускорения видео Intel VA-API кадр декодируется непосредственно в разделяемую память (Unified Memory). Затем с помощью механизма OpenVINO Remote Tensors софт передает встроенному GPU или NPU не сами мегабайты пикселей, а хэндл на физический буфер. Строгая модель владения Rust гарантирует, что данные проходят путь от декодера до инференса без единого системного копирования, обходя «стену памяти».
- Асинхронность кода зеркально отражает асинхронность блоков Intel. Тяжелые вычисления нейросетей не должны конкурировать с асинхронным рантаймом приложения. Запуск инференса внутри общей
tokio-задачи приводит к тому, что планировщик хаотично мечет потоки между P- и E-ядрами, вызывая промахи кэша и разрушая p99.9 тайминги. Правильный Co-Design — это использование неблокирующего OpenVINO Async API (AsyncInferRequest). Поток CPU на Rust лишь отправляет задачу в железную очередь ускорителя и мгновенно возвращает управление в рантаймtokio(через механизм Futures). При этом внутренние вычислительные потоки OpenVINO аппаратно привязываются (Thread Affinity / CPU Pinning) к выделенным физическим ядрам, изолированно от основного приложения.
Разрушение барьера между софтом и железом — это не временная мера. В эпоху окончания закона Мура и доминирования специализированных ИИ-ускорителей, Hardware-Software Co-Design — это единственный способ заставить наш стек на Rust работать на пределе физических возможностей железа без перегрева ноды и пропуска кадров.
5. Сдвиг от пассивного мониторинга к сквозной Наблюдаемости (Observability)
Пятый тектонический сдвиг произошёл в дисциплине диагностики и контроля распределённых вычислительных сред.
Долгое время классическая софтверная школа оперировала парадигмой пассивного мониторинга (Monitoring). Инженеров учили: «Безопасность системы контролируется набором предопределённых индикаторов отказов (метрики CPU, RAM, остаток диска) и реактивными текстовыми логами». Система рассматривалась как чёрный ящик, а инцидент регистрировался постфактум, когда значение метрики пересекало критический порог. Эта иллюзия стабильности разбилась о нелинейную природу современных асинхронных архитектур и распределённых Edge-сетей.
В условиях многопоточного рантайма Rust (tokio) и гетерогенных вычислений традиционный мониторинг беспомощен. Система может находиться в состоянии скрытого каскадного отказа: универсальные метрики CPU и памяти рапортуют об идеальном здоровье (загрузка 50%), процессы живы, но из-за микро-задержек на шине памяти (Memory Wall), коллизий в очередях планировщика или аппаратного троттлинга чипа часть кадров незаметно дропается. Найти первопричину такого сбоя по классическим изолированным логам физически невозможно, так как они лишены сквозной причинно-следственной связи.
Ответом индустрии на этот кризис стал переход к парадигме Observability (Наблюдаемости), математические основы которой восходят к теории линейных систем управления Рудольфа Калмана (1960). Наблюдаемость — это мера того, насколько точно можно восстановить внутреннее состояние системы на основе анализа её внешних проявлений.
Истоки концепции и индустриальный контекст:
Переломный момент произошёл в 2019 году, когда под эгидой фонда CNCF (Cloud Native Computing Foundation) случилось слияние двух независимых проектов распределённого трейсинга: OpenTracing (Uber) и OpenCensus (Google). Результатом стал проект OpenTelemetry (OTel), ставший вторым по активности в истории CNCF после Kubernetes. Индустрия пришла к консенсусу: вместо фрагментированных «силосов данных» (логи сами по себе, метрики сами по себе) необходима единая сквозная спецификация, связывающая триаду данных телеметрии — Logs, Metrics, Traces — общим распределённым контекстом (Trace Context).
Если сводить суть концепции к прикладному уровню:
Мы больше не пытаемся угадать все сценарии сбоев на этапе проектирования. Вместо этого мы насыщаем каждый этап трансформации данных уникальным сквозным контекстом. Это позволяет локализовать аномалии любой природы на лету, не выкатывая отладочный код и не прерывая работу ноды.
Сдвиг в сторону Наблюдаемости превращает диагностику Edge-ноды из слепого чтения текстовых логов в точную инженерную дисциплину. В условиях, когда физический доступ к устройству закрыт, а входящие порты заблокированы правилами Zero Trust, Observability становится единственным окном во внутреннее состояние edge-системы.
Единый концептуальный вектор пяти парадигм
Если свести вместе Zero Trust, Resilience Engineering, Mechanical Sympathy, Hardware-Software Co-Design и Observability, становится видна их строгая концептуальная симметрия и общая логика отказа от классических абстракций:
| Характеристика | Security (Zero Trust) | Reliability (Resilience Engineering) | Efficiency (Mechanical Sympathy / DOD) | Integration (Hardware-Software Co-Design) | Diagnostic (Observability) |
|---|---|---|---|---|---|
| Исторический триггер | Operation Aurora (2009) → BeyondCorp (2014) | Normal Accidents (1984) → Chaos Monkey (2011), Google SRE (2016) | Memory Wall (1995) → The Free Lunch Is Over (2005) → LMAX Disruptor (2011), DOD (2014) | Кризис масштабирования Деннарда (2005) → Золотой век Co-Design (Крис Латтнер, середина 2010-х) | Кризис асинхронных сред (2015) → Слияние OpenTracing и OpenCensus в OpenTelemetry (2019) |
| Базовый постулат | Assume Breach (Считай, что периметр пробит) | Assume Failure (Считай, что сервис уже упал) | Assume Constraint (Считай, что ресурсы жестко ограничены) | Assume Specialization (Считай, что универсальный CPU мёртв) | Assume Unknown Unknowns (Считай, что ты не знаешь, где именно софт сломается) |
| Ключевой принцип | Never trust, always verify (Никому не доверяй, проверяй всё) | Design for failure (Проектируй с расчётом на непрерывные сбои) | Design for data layouts (Проектируй под структуру кэша и памяти) | Design for silicon topology (Проектируй под физические блоки чипа) | Instrument everything with context (Насыщай любое событие сквозным Trace/Span ID) |
| Отвергнутая иллюзия | «Внутренняя сеть полностью безопасна» | «Можно написать код без единого бага» | «Железо компенсирует неэффективный код» | «Софт должен быть полностью абстрагирован от железа» | «Можно заранее предугадать все сценарии сбоев и повесить алерты» |
| Главная цель | Ограничение радиуса атаки (Blast Radius Control) | Ограничение радиуса сбоя и контролируемая деградация | Гарантированный детерминизм рантайма (Tail Latency) и отсутствие OOM | Максимальная утилизация сопроцессоров без перегрева чипа (TDP) | Прозрачность причинно-следственных связей нелинейных сбоев на лету |
| Инженерные механизмы | Secure Boot, dm-verity, Least Privilege, Hardware Root of Trust, mTLS | Изолированные акторы (Bulkheads), Store-and-Forward, Crash-Only | Bounded queues, статическая преаллокация, плоские таблицы (SoA) | INT8/INT4 Quantization, VA-API / DMA-BUF Zero-Copy, Thread Affinity / CPU Pinning | Сквозной Trace Context, бинарная структурированная телеметрия, локальный OTel Collector |
| Ключевые метрики | Поверхность атаки (Attack Surface), Time-to-Detect (MTTD) | SLO, Error Budget, MTTR, доступность контура записи | p99.9 latency кадра, дрейф RAM за 30 дней, Bandwidth шины памяти (ГБ/с) | Эффективный FPS на ватт, температура SoC (°C), коэффициент утилизации NPU/GPU | Метрики распределения (p95/p99.9), глубина очередей рантайма, процент семплирования |
Примечание: «Assume Constraint», «Assume Specialization» и «Assume Unknown Unknowns» — авторские термины; квинтет базовых постулатов — риторическое обобщение, а не формальная модель.
Конфликты парадигм: где теория сталкивается с реальностью
Зрелая архитектура отличается от академической тем, что открыто признаёт и разрешает внутренние противоречия между парадигмами. Часть из них — скорее компромиссы реализации, чем фундаментальные конфликты:
- Zero Trust против Zero-Copy: Шифрование требует лишнего прохода по данным. Разрешение: сырые декодированные кадры на пути к NPU не шифруются — они не покидают SoC и общую память. Шифруется только сжатый архивный сегмент перед записью на накопитель: AES-GCM исполняется либо на ядрах CPU с аппаратными инструкциями (ARMv8 Crypto Extensions / AES-NI), либо на выделенном крипто-движке SoC, если он есть и для него есть драйвер. Объём шифруемых данных — это битрейт сжатого видео (единицы МБ/с), примерно на два порядка меньше трафика несжатых кадров, поэтому конфликт с zero-copy невелик.
- Resilience против Bounded Storage: Паттерн Store-and-Forward стремится бесконечно копить события при обрыве сети, а принцип Bounded Storage жестко запрещает превышать квоту диска. Разрешение: Введение многоуровневых приоритетов вытеснения (Eviction Policy). Критические метаданные и алерты (
PersonDetected) хранятся в приоритетной очереди с гарантией доставки, тогда как тяжёлые видеоклипы при заполнении диска вытесняются по принципу FIFO, либо сжимаются с понижением битрейта и частоты кадров. - Zero Trust против Observability: Нода не имеет открытых входящих портов, поэтому стандартный pull-сбор метрик (например, опрос прометеусом через HTTP-эндпоинт) невозможен. Разрешение: Переход на чистый push-механизм: локальный брокер телеметрии сам открывает исходящую TLS-сессию в облако. При этом буфер очередей метрик также подчиняется принципу Bounded Resources: при длительном офлайне детальные трейсы схлопываются в агрегированные гистограммы, не расходуя диск.
- Co-Design против Observability: Глубокий трейсинг (OpenTelemetry) и профилирование конвейера на каждом этапе трансформации кадра создают огромный оверхед по памяти и CPU, уничтожая выигрыш от аппаратного ускорения. Разрешение: Динамическое контекстное семплирование (Contextual Sampling). Сквозной
TraceIDгенерируется рантаймом Rust для каждого кадра и неявно пробрасывается через OpenVINO/ONNX Runtime контексты без аллокаций. Однако сбор и сериализация полных метрик (задержки слоев нейросети, шины памяти) активируются только триггерно — если p99.9 латентности кадра превысил целевой бюджет (например, >33.3 мс) или принудительно для 0.1% кадрового потока. - Co-Design против Resilience: Жесткая привязка вычислительных потоков рантайма (OpenVINO TBB / ORT Thread Pool) к физическим ядрам процессора (Thread Affinity)保護 защищает кэш от промахов, но лишает планировщик ОС гибкости. Если одно из ядер CPU перегружено системным прерыванием, жестко привязанный поток инференса «зависнет», порождая пиковую задержку (Tail Latency). Разрешение: Выделение изолированных ядер под инференс на уровне ядра Linux (параметр загрузки
isolcpusилиcgroups), полностью выводящее их из-под общего планировщика операционной системы иtokio. Конвейеры инференса оперируют на выделенном монопольном куске кремния, гарантируя предсказуемость рестарта в рамках модели Crash-Only.
Практика Edge-хаоса: Chaos Engineering на стенде
На Edge-ноде теоретические сбои становятся повседневной реальностью. Ниже — иллюстративные ориентиры из практики (не академические данные; конкретные значения сильно зависят от класса накопителя, модема и условий эксплуатации):
- Флеш-память потребительского класса под круглосуточной непрерывной записью выходит из строя за 9–14 месяцев.
- Промышленный LTE-модуль на удалённом объекте теряет базовую станцию от 3 до 10 раз в сутки.
- Внезапные скачки напряжения (Brownout) приводят к отключению ноды в момент сброса кэша контроллера SSD, гарантированно разрушая незавершённые секторы данных.
Для проверки нашего «Ходячего скелета» мы построили автоматизированный стенд аппаратного и программного Fault Injection, запускаемый в CI (программные сбои — на каждый коммит, аппаратные, включая потерю питания, — на стенде по расписанию и перед релизом; подробнее — в разделе «Чего пока не хватает»):
| Вектор сбоя | Инструмент эмуляции | Проверяемый инвариант |
|---|---|---|
| Обрыв сети во время отправки батча | iptables -A OUTPUT -j DROP | Отсутствие зависания сокета и корректный retry из redb |
| Скачок загрузки CPU до 100% | stress-ng --cpu 8 --vm 2 --vm-bytes 1G | Приоритет конвейера видео над телеметрией (cgroups) |
| 40% потерь пакетов от RTSP-камеры | tc qdisc add dev eth0 root netem loss 40% | Детекция broken-stream и реконнект без OOM |
| Мгновенное отключение питания (Power Loss) | Управляемое реле питания (Smart PDU Relay) | Сохранность ACID-базы redb без повреждения B-дерева |
Только прогнав каркас через аппаратную матрицу хаос-тестов и доказав, что радиус поражения (Blast Radius) любого сбоя строго изолирован, мы получаем право наполнять систему бизнес-логикой.
Что входит в скелет, а что нет: правило необратимости
Описанная ниже архитектура — целевая. Ходячий скелет — не она вся, а её тонкий срез. Если попытаться построить всё сразу, мы получим тот самый Big Design Up Front, от которого когда-то уходил Agile: месяцы проектирования без обратной связи от реального железа.
Критерий отбора простой, и он следует из принципа, который мы уже применяли к оптимизациям: в скелет попадает то, что нельзя дёшево переделать после выхода на объекты; всё остальное нарастает итерациями.
- Необратимое (в скелет): раскладка разделов накопителя; формат идентичности устройства и процесс заводского provisioning; цепочка Secure Boot; модель привилегий (кто какими ключами и устройствами владеет) и контракты сообщений между процессами; формат хранимых записей и их версионирование; модель владения памятью и политика потерь очередей; протокол управления (версионирование и подпись Desired State); сам механизм A/B-обновления с откатом — если OTA сломан, устройство нельзя починить удалённо.
- Обратимое (откладываем): модель нейросети и её квантование; редактор правил; агрегация телеметрии; аппаратный crypto-offload; canary-раскатка; тонкая настройка seccomp-профилей и DVFS.
Число процессов к необратимому не относится: если компоненты общаются только сериализуемыми сообщениями, процесс можно разделить или объединить позже.
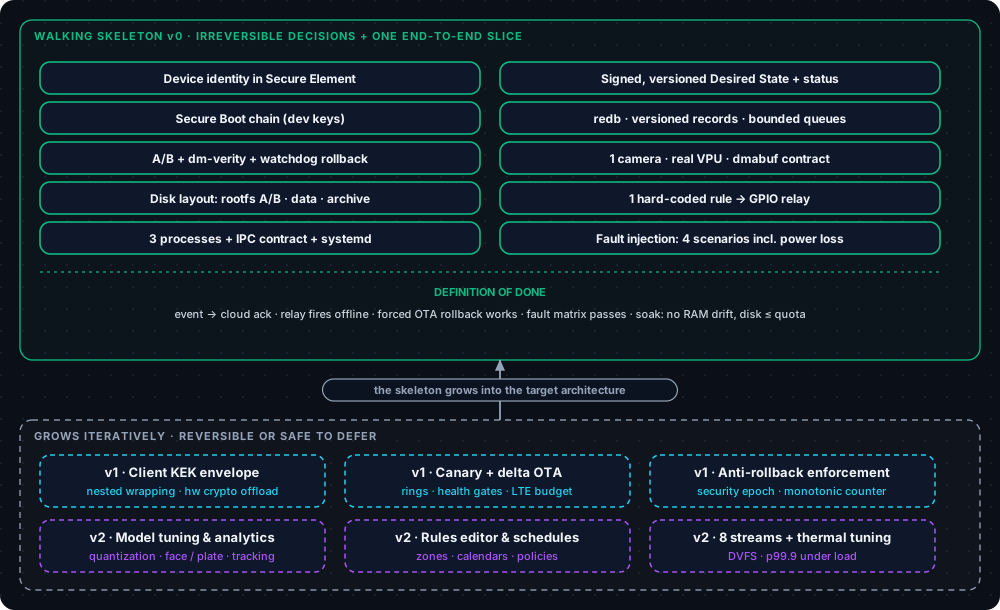
| Область | В скелете (v0) | Откладываем | Почему так |
|---|---|---|---|
| Идентичность и безопасность | Уникальный ключ и сертификат в Secure Element при производстве; цепочка Secure Boot (пока с dev-ключами); закрытые порты; mTLS | Вложенное шифрование архива с Client KEK; аппаратный crypto-offload | Provisioning и цепочка доверия не переделываются в поле; формат конверта получает номер версии уже в v0 (в v0 — один слой Node KEK) |
| Накопитель и обновления | Разделы: boot, rootfs A/B (read-only, dm-verity), data (redb, логи), отдельный раздел архива; готовый OTA-инструмент (RAUC / SWUpdate / Mender) с A/B + watchdog + принудительным тестом отката | Включение anti-rollback (дизайн — в v0), canary-раскатка, delta-обновления | Разметку диска нельзя поменять на тысячах устройств; откат — единственная страховка от «кирпича» |
| Границы процессов | Три процесса (node-core, video-pipeline, vault); IPC-контракт; жизненный цикл под systemd (рестарты с backoff, watchdog) | Тонкие seccomp-профили, Landlock, настройка cgroups; разделение video-pipeline на два процесса — по данным soak-теста | Модель привилегий и контракты дорого менять; число процессов — нет, если обмен идёт сообщениями |
| Хранилище и очереди | redb с версионируемыми записями; event_queue с жёсткой квотой и двумя приоритетами (critical и остальное); политика потерь по типам данных | Агрегация на 80%, тонкая градация приоритетов, сжатие архива с понижением битрейта | Формат записей и политика потерь — часть контракта |
| Управление | Подписанный версионированный Desired State; статус observed_generation; last-known-good; один цикл reconcile() | Расписания, сложные зоны аналитики, богатые политики | Протокол управления нужно версионировать с первого дня |
| Видео-конвейер | Одна реальная камера; реальный VPU-декодер; dmabuf-контракт; ремукс в MP4; детектор-заглушка или готовая модель «как есть» | Квантование и тюнинг моделей, 8 потоков, thermal/DVFS-тюнинг | Модель владения памятью необратима; качество детекции — обратимо |
| Автономные реакции | Одно жёстко заданное правило → GPIO-реле | Редактор правил, расписания, зоны | Доказывает автономный путь без облака |
| Наблюдаемость и сервис | Push логов и метрик через Vector с ограниченным буфером; исходящий туннель диагностики по запросу | Агрегированные гистограммы, дашборды | Узел без диагностики в поле не обслуживается |
| Fault injection | Четыре сценария матрицы (обрыв сети, CPU-стресс, потери пакетов, потеря питания) | Расширенные сценарии, длительные soak-тесты | Скелет проверяется хаосом — иначе это не скелет |
Критерий готовности скелета (Definition of Done)
- Одна камера → событие (пусть и от детектора-заглушки) → алерт в облаке →
PUBACK→ удаление из очереди. - Автономное срабатывание реле при отключённой сети.
- OTA: успешное обновление и принудительный откат (заведомо сломанная прошивка сама возвращается на предыдущий слот без участия человека).
- Четыре сценария fault injection проходят; потеря питания проверена серией циклов, а не одним прогоном.
- Soak-тест (сутки и больше) без дрейфа RAM и без роста диска сверх квоты; p99.9 кадра измерен, а не предположен.
Скелет остаётся «ходячим»: в нём ровно то, без чего остальное нельзя безопасно наращивать, и ничего сверх этого. Остальная часть статьи описывает целевую архитектуру, из которой этот срез вырастает; под каждым заголовком отмечено, что из неё входит в v0.
Целевая архитектура Edge-ноды: из чего вырастает скелет
Архитектура узла объединяет концепции Cloud-Native систем, строго ограниченные физическими возможностями edge-устройств и реализованные на языке Rust. Это карта целевого состояния: что из неё попадает в v0, отмечено в блоках «В скелете» под заголовками разделов.
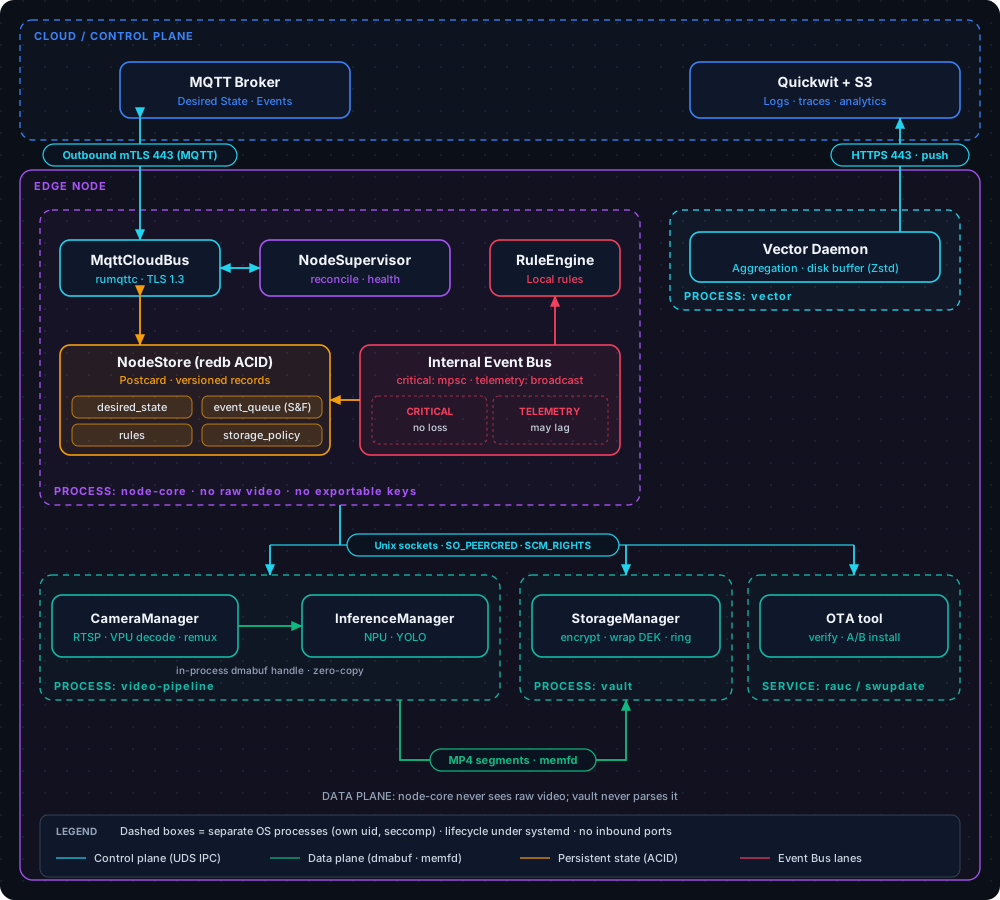
Пунктирные контейнеры на схеме — границы процессов ОС: node-core (супервизор, правила, облачная шина, хранилище), video-pipeline (камера и инференс), vault (шифрование и архив) и vector; рядом — готовый OTA-сервис (RAUC / SWUpdate). Видеоданные ходят по прямым каналам, минуя node-core; жизненным циклом процессов управляет systemd.
1. Модель состояния: Declarative State Reconciliation
В скелете (v0): подписанный и версионированный Desired State, один цикл
reconcile(), отчёт ноды о фактическом состоянии, last-known-good (см. раздел «Чего пока не хватает»).Позже: расписания, сложные зоны аналитики, богатые политики.
Большинство распределённых систем теряют консистентность из-за императивного управления («переключи камеру на 1080p прямо сейчас»). Команду, отправленную офлайн-ноде, можно доставить позже через persistent session и QoS 1, но тогда приходится разбираться с порядком, повторами и устаревшими командами. Если команда потеряна или применена дважды, возникает расхождение между тем, что считает облако, и фактическим состоянием ноды (state drift).
Мы используем декларативный подход, адаптированный из архитектуры Kubernetes:
- Облачный бэкенд через MQTT-брокер (EMQX) публикует документ Desired State (Желаемое состояние ноды: перечень камер, параметры детекции, активные расписания).
- На ноде корневой оркестратор —
NodeSupervisor— выполняет постоянный цикл согласования (Control Loop). - Метод
.reconcile()сравнивает фактическое состояние дочерних акторов с желаемым и устраняет расхождения:
// Упрощённый концепт Control Loop в составе NodeSupervisor
const RECONCILE_TIMEOUT: Duration = Duration::from_secs(3);

pub async fn run_reconciliation_loop(
   supervisor: Arc<NodeSupervisor>,
   mut desired_state_rx: watch::Receiver<NodeDesiredState>,
   mut shutdown_rx: broadcast::Receiver<()>,
) {
   // watch хранит только ПОСЛЕДНЕЕ желаемое состояние: если облако прислало три версии,
   // пока нода была офлайн, она применит актуальную, а не будет проигрывать все по очереди.
   // Начальное значение канала загружается из NodeStore, поэтому после рестарта или потери
   // связи нода продолжает работать по последнему известному Desired State.
   let mut interval = tokio::time::interval(Duration::from_secs(5));
   interval.set_missed_tick_behavior(MissedTickBehavior::Delay);
   let mut desired_open = true;

   loop {
      tokio::select! {
            _ = shutdown_rx.recv() => {
                log::info!("Завершение работы супервизора по сигналу shutdown");
                break;
            }
            // Новое состояние применяем сразу, не дожидаясь очередного тика
            res = desired_state_rx.changed(), if desired_open => {
                if res.is_err() {
                    // Источник закрыт: не уходим в busy-loop, продолжаем по тикам
                    log::warn!("Источник Desired State закрыт, работаем по последнему известному состоянию");
                    desired_open = false;
                    continue;
                }
                let desired = desired_state_rx.borrow_and_update().clone();
                reconcile_all(&supervisor, &desired).await;
            }
            // Периодическая сверка: ловит дрейф, даже если новых команд не было
            _ = interval.tick() => {
                let desired = desired_state_rx.borrow().clone();
                reconcile_all(&supervisor, &desired).await;
            }
        }
   }
}

async fn reconcile_all(supervisor: &NodeSupervisor, desired: &NodeDesiredState) {
   for manager in supervisor.managers() {
      // Таймаут: один зависший менеджер не должен блокировать сверку остальных
      match tokio::time::timeout(RECONCILE_TIMEOUT, manager.reconcile(desired)).await {
         Ok(Ok(())) => {}
         Ok(Err(err)) => {
            log::warn!(
                    target: "supervisor",
                    "Ошибка реконсиляции менеджера {}: {err:?}. Применяем backoff",
                    manager.name()
                );
            manager.handle_reconcile_failure().await;
         }
         Err(_) => {
            log::warn!(
                    target: "supervisor",
                    "Реконсиляция менеджера {} превысила таймаут. Применяем backoff",
                    manager.name()
                );
            manager.handle_reconcile_failure().await;
         }
      }
   }
}
Desired State хранится как «последнее значение» (tokio::sync::watch): если облако прислало несколько версий, пока нода была офлайн, она применит актуальную, а не будет проигрывать их все. Последнее известное состояние сохраняется в NodeStore, поэтому после рестарта нода работает автономно.
Если RTSP-поток отвалился, CameraManager переходит в состояние деградации и методично пытается переподключиться по экспоненциальному таймеру (Exponential Backoff с ограничением верхнего порога — Backoff Ceiling). Операции reconcile() идемпотентны на уровне каждого менеджера: повторное применение того же Desired State ничего не меняет, поэтому потеря или дублирование пакетов не нарушает конечной консистентности (eventual consistency). Для менеджеров, вынесенных в отдельные процессы, reconcile() — это отправка желаемой конфигурации по IPC и проверка подтверждения.
2. Модель данных: Store-and-Forward, Postcard и Crash-Safe база данных redb
В скелете (v0):
redbс версионируемыми записями,event_queueс жёсткой квотой и двумя приоритетами (critical / остальное), политика потерь по типам данных.Позже: агрегация телеметрии на 80% заполнения, тонкая градация приоритетов, сжатие архива с понижением битрейта.
Для работы в офлайне нода буферизует события в локальной встроенной БД. Мы используем redb — встраиваемую ACID-базу данных на чистом Rust. Это не значит, что SQLite плох: в режиме WAL с synchronous=FULL он тоже надёжно переживает потерю питания и намного дольше проверялся в бою. Выбор redb мотивирован чистым Rust (без C-зависимости и FFI), типизированным API таблиц и предсказуемой моделью памяти. Проект более молодой, поэтому изоляция за трейтом NodeStore — страховка, а не формальность:
- Устойчивость к сбоям питания (Copy-on-Write):
redbпостроена на Copy-on-Write: обновлённые данные записываются на свободные страницы, а переключение указателя корня B-дерева происходит атомарно только после успешногоfsync. Это резко снижает риск повреждения и избавляет от журнала WAL, но не снимает зависимости от накопителя: гарантия работает, только если устройство честно выполняет flush. Потребительские eMMC/SSD без защиты от потери питания (PLP) могут нарушать порядок записи или портить страницы на уровне собственного FTL. Поэтому мы дополняем БД выбором накопителя (с PLP или с хорошо документированным поведением), контрольными суммами и проверкой на стенде с реальным отключением питания. - Компактная бинарная сериализация: Все системные структуры (
CameraConfig,StoragePolicy,SecurityRule,EventQueueItem) сериализуются с помощью Postcard — компактного бинарногоno_std-формата. Это исключает накладные расходы на парсинг JSON/XML и минимизирует паразитные аллокации в куче. Но Postcard не самоописываемый (нет имён полей и тегов): состав и порядок полей — часть контракта. Поэтому каждая запись в персистентной очереди оборачивается в версионируемый enum (EventV1,EventV2, …) с явным номером схемы, а пока новая прошивка не подтверждена, она пишет записи в формате, который читает и предыдущая версия, — иначе после автоматического отката старая прошивка не прочитает очередь.
Доступ к хранилищу изолирован за трейтом NodeStore. Это формирует строгий слой абстракции: если в будущем специфическое железо потребует смены движка, вся бизнес-логика менеджеров останется нетронутой.
#[async_trait]
pub trait NodeStore: Send + Sync {
   async fn enqueue_event(&self, event: &EdgeEvent) -> Result<EventId, StoreError>;
   async fn dequeue_event_batch(&self, batch_size: usize) -> Result<Vec<PersistedEvent>, StoreError>;
   async fn mark_events_committed(&self, ids: &[EventId]) -> Result<(), StoreError>;
   async fn get_storage_quota(&self) -> Result<StorageQuotaInfo, StoreError>;
}
Приоритезация очередей (Bounded Event Queue)
В соответствии с принципом Bounded Resources, локальная таблица event_queue строго лимитирована по объёму:
- При заполнении очереди до 80% система начинает агрегировать однотипную телеметрию (схлопывать повторяющиеся статусы сенсоров за временное окно).
- При заполнении до 95% низкоприоритетные логи (
Debug,Trace,Info) сбрасываются. - Критические события безопасности (
PersonDetected,TamperAlarm,TamperSensorTriggered) имеют абсолютный приоритет и сохраняются вплоть до исчерпания гарантированной квоты таблицы. Если квота критических событий всё же исчерпана, вытесняются самые старые критические записи (кольцо), а факт потери фиксируется счётчикомevents_dropped_total, который уходит в облако при первом соединении.
3. Модель потоков: изолированные процессы и акторы
В скелете (v0): три процесса (
node-core,video-pipeline,vault) и IPC-контракт; жизненный цикл — под systemd (рестарты с backoff, watchdog); камера реальная, детектор — заглушка или готовая модель «как есть».Позже: тонкие seccomp-профили и Landlock, настройка cgroups, разделение
video-pipelineна два процесса (если это подтвердят данные soak-теста), все менеджеры в полной функциональности.
Архитектура исключает совместный доступ к изменяемому состоянию через россыпь мьютексов (Arc<Mutex<T>>), провоцирующих взаимные блокировки (Deadlocks) и contention в асинхронном рантайме. Вместо этого логика разделена на акторов, общающихся сообщениями. Но у изоляции два уровня, и их важно не путать:
- Логическая — отдельные tokio-таски в одном процессе. Защищает от взаимных блокировок и позволяет перехватить Rust-панику, но не защищает от segfault/UB в C-библиотеке, от
abort()и от OOM: падает весь процесс. Границы привилегий она тоже не создаёт — все таски делят одно адресное пространство. - Жёсткая — отдельные процессы ОС. Только она реально ограничивает радиус сбоя и реализует Least Privilege.
Поэтому всё, что работает с недоверенным вводом (парсинг RTSP, декодер, ремукс), с проприетарными C-библиотеками (VPU/NPU) или с ключами, выносится в отдельные процессы. Число процессов мы держим минимальным: каждый лишний процесс — это ещё один IPC-контракт, ещё один unit в systemd и ещё одна строка в матрице тестов.
| Процесс | Компоненты | Доступ и изоляция |
|---|---|---|
node-core | NodeSupervisor, RuleEngine (локальные реакции вроде «пересечена линия — замкнуть реле»), MqttCloudBus, NodeStore, Internal Event Bus, OtaManager (политика: когда ставить обновление; сам установщик — отдельный сервис) | Не видит сырое видео; ключи не держит в памяти: TLS подписывается через Secure Element |
video-pipeline | CameraManager (RTSP, VPU-декодирование, ремукс сжатых пакетов в MP4) и InferenceManager (NPU) | Сеть только до камер (IPAddressAllow), устройства VPU/NPU/RGA; нет ключей, нет выхода в облако, нет доступа к NodeStore |
vault | StorageManager: шифрование готовых MP4-сегментов, запечатывание DEK, кольцевой архив, квоты | Единственный процесс с операциями Node KEK; запись только в раздел archive; парсеров видео внутри нет |
| OTA-инструмент (RAUC / SWUpdate / Mender) | Скачивание, проверка подписи, запись в неактивный слот, взаимодействие с загрузчиком | Отдельный systemd-сервис с правом писать в разделы и в окружение загрузчика; node-core управляет им через D-Bus или CLI, но сам этих прав не имеет |
Почему камера и инференс — один процесс
Обе части обрабатывают один и тот же недоверенный видеопоток через вендорские библиотеки, у обеих нет ни ключей, ни выхода в облако — значит, при компрометации злоумышленник получает одно и то же. А внутри одного процесса кадр передаётся как обычный хэндл буфера: никакого обмена дескрипторами и лишнего IPC на горячем пути.
Граница между ними проведена на уровне кода: CameraManager и InferenceManager общаются через trait’ы (FrameSource, Detector) и сообщения. Если данные soak-теста покажут, что NPU-runtime падает или зависает заметно чаще, чем ingest, процесс делится на два без переписывания логики. Это решение мы принимаем по данным, а не заранее.
Почему vault крошечный
vault получает готовые MP4-сегменты как непрозрачные байты и не разбирает их. Парсинг видео — самая уязвимая часть конвейера, поэтому он остаётся в video-pipeline, который ключей не видит. Тогда уязвимость в парсере не открывает доступ к ключевым операциям.
Оговорка по железу: разграничение доступа к Secure Element между процессами зависит от платформы. TPM 2.0 с resource manager выдаёт ключи с политиками на процесс. Простой I²C-крипточип сам процессы не различает: доступ к нему ограничивается правами на устройство, и к чипу ходит один процесс. Тогда подпись TLS для node-core придётся проксировать через тот же процесс-хранитель.
Кто следит за процессами: systemd
Жизненный цикл процессов мы не пишем сами: systemd уже умеет рестарты с задержкой, watchdog, лимиты памяти, песочницу и socket activation. Рестарты с растущей задержкой (RestartSteps и RestartMaxDelaySec) доступны в systemd 254+; на более старых версиях остаётся фиксированный RestartSec. NodeSupervisor отвечает за логику: раздаёт Desired State по IPC, собирает статусы, решает, что компонент Degraded, и при длительной логической неисправности просит systemd о перезапуске через D-Bus.
# /etc/systemd/system/rockedge-video.service  (упрощённый пример)
[Unit]
Description=RockEdge video pipeline (camera ingest + inference)

[Service]
# Процесс сам сообщает READY=1 через sd_notify
Type=notify
User=rockedge-video
Group=rockedge-video
ExecStart=/usr/libexec/rockedge/video-pipeline

# Падения и зависания
Restart=on-failure
RestartSec=500ms
# systemd 254+: задержка растёт ступенями до RestartMaxDelaySec
RestartSteps=6
RestartMaxDelaySec=60
# Процесс обязан регулярно слать WATCHDOG=1
WatchdogSec=10s

# Ресурсы и песочница
MemoryMax=1536M
NoNewPrivileges=yes
ProtectSystem=strict
ProtectHome=yes
PrivateTmp=yes
SystemCallFilter=@system-service
RestrictAddressFamilies=AF_UNIX AF_INET AF_INET6
# Сеть только до камер
IPAddressDeny=any
IPAddressAllow=192.168.50.0/24
# Устройства: имена зависят от BSP (пример для Rockchip), узел NPU добавляется по вашей платформе
DevicePolicy=closed
DeviceAllow=/dev/mpp_service rw
DeviceAllow=/dev/rga rw
# /etc/systemd/system/rockedge-video.socket (сокет, через который video-pipeline говорит с node-core)
[Socket]
ListenStream=/run/rockedge/video.sock
SocketUser=rockedge-core
SocketGroup=rockedge-video
SocketMode=0660Сокет заводится отдельный на каждого пира (video.sock, vault.sock): права файловой системы и проверка SO_PEERCRED — два независимых барьера. node-core получает готовый сокет через socket activation (например, крейт listenfd).
Watchdog ловит не только падения, но и зависания драйвера, если сообщать «жив» только при реальном прогрессе:
// Сообщаем systemd «жив» только если рабочий цикл действительно продвигается
let progressed = frames_processed.load(Ordering::Relaxed) > last_seen;
if progressed {
let _ = sd_notify::notify(false, &[sd_notify::NotifyState::Watchdog]);
}
Механика взаимодействия и локализации сбоев
- Ограниченные каналы и политика потерь по типу данных. Все каналы создаются с фиксированной ёмкостью, но что делать при переполнении зависит от того, что по каналу идёт:
- Кадры — «побеждает последний кадр»: фиксированное кольцо из N буферов внутри
video-pipeline;InferenceManagerвсегда берёт самый свежий, а устаревшие перезаписываются, рост RAM нулевой. Аналог на каналах —tokio::sync::watch. Режима drop-oldest уtokio::sync::mpscнет. - Критические события (
PersonDetected,TamperAlarm) — не теряются: каждый критический потребитель (RuleEngine,NodeStore) получает событие по собственному ограниченномуmpscчерезsend().await; при перегрузке включается backpressure, а не молчаливая потеря. Между процессами событие подтверждаетсяAckпосле записи. - Телеметрия и статусы —
broadcast: отстающий подписчик получаетLaggedи пропускает устаревшие сообщения, что для метрик допустимо. Для критических событийbroadcastиспользовать нельзя: он как раз молча теряет старые сообщения у медленного подписчика.
- Кадры — «побеждает последний кадр»: фиксированное кольцо из N буферов внутри
- Изоляция сбоев. Падение
video-pipeline(например, SIGSEGV в C-библиотеке декодера) не затрагиваетnode-coreиvault: systemd видит завершение процесса, иRestart=поднимает его заново с растущей задержкой; перед запуском можно сбросить аппаратный контекст VPU/NPU черезExecStartPre=. Внутри процесса лёгкие акторы остаются tokio-тасками, и их паника перехватывается черезJoinHandle. От segfault и UB это не защищает — именно поэтому код, работающий с недоверенным вводом и C-библиотеками, вынесен в отдельные процессы:
// Контроль жизненного цикла изолированного актора внутри процесса
// Важно: перехват паники через JoinHandle работает только при panic = "unwind" в профиле сборки.
const MIN_DELAY: Duration = Duration::from_millis(500);
const MAX_DELAY: Duration = Duration::from_secs(60);
const STABLE_RUN: Duration = Duration::from_secs(60);

/// Ждёт backoff; возвращает false, если за это время пришёл shutdown.
async fn wait_backoff(delay: &mut Duration, shutdown_rx: &mut broadcast::Receiver<()>) -> bool {
   tokio::select! {
        _ = shutdown_rx.recv() => false,
        _ = tokio::time::sleep(*delay) => {
            *delay = (*delay * 2).min(MAX_DELAY);
            true
        }
    }
}

pub async fn supervise_manager_task<M: Manager + 'static>(
   manager: Arc<M>,
   mut shutdown_rx: broadcast::Receiver<()>,
) {
   let mut restart_delay = MIN_DELAY;

   loop {
      let mgr = manager.clone();
      let started_at = Instant::now();
      let mut handle = tokio::spawn(async move { mgr.start_processing_loop().await });

      tokio::select! {
            _ = shutdown_rx.recv() => {
                log::info!("Штатная остановка менеджера {}", manager.name());
                // Без abort() таска осталась бы жить в фоне после выхода из супервизора
                handle.abort();
                let _ = handle.await;
                break;
            }
            res = &mut handle => {
                match res {
                    Ok(Ok(())) => {
                        log::info!("Менеджер {} завершился штатно", manager.name());
                        break;
                    }
                    Ok(Err(err)) => {
                        log::error!("Критическая ошибка менеджера {}: {err:?}", manager.name());
                    }
                    Err(join_err) if join_err.is_panic() => {
                        log::error!("Паника внутри таски менеджера {}: {join_err:?}", manager.name());
                    }
                    Err(join_err) => {
                        log::warn!("Таска менеджера {} была отменена: {join_err:?}", manager.name());
                    }
                }
            }
        }

      // Компонент, проработавший стабильно, получает «чистый» счётчик backoff
      if started_at.elapsed() >= STABLE_RUN {
         restart_delay = MIN_DELAY;
      }
      log::info!("Перезапуск менеджера {} супервизором...", manager.name());
      if !wait_backoff(&mut restart_delay, &mut shutdown_rx).await { break; }
   }
}
Пример: как выглядит IPC между процессами (Unix-сокет, Postcard)
Протокол минимален: длина (u32) и сообщение в Postcard. На стороне приёмника проверяется, кто подключился, событие подтверждается только после записи, а крупные данные (сегмент видео) передаются дескриптором, а не байтами. В реальной системе Event принимает node-core, а SegmentFd — vault; здесь они объединены для краткости.
#[derive(Serialize, Deserialize, Debug)]
enum Msg {
   Hello { proc_name: String, proto: u16 },
   Event { event_id: u64, kind: String, confidence: f32 },
   // Сам сегмент передаётся дескриптором, а не байтами
   SegmentFd { seq: u64, len: u32 },
   Ack { event_id: u64 },
}

// Фрейминг: [u32 длина][Postcard]; читаем РОВНО len байт
async fn recv_msg(s: &mut UnixStream) -> io::Result<Msg> {
   let mut len = [0u8; 4];
   s.read_exact(&mut len).await?;
   let len = u32::from_le_bytes(len) as usize;
   if len > MAX_MSG { return Err(io_err("сообщение слишком большое")); }
   let mut body = vec![0u8; len];
   s.read_exact(&mut body).await?;
   postcard::from_bytes(&body).map_err(io_err)
}

async fn handle_peer(
   mut s: UnixStream,
   store_tx: mpsc::Sender<(u64, oneshot::Sender<()>)>,
   expected_uid: u32,
) -> io::Result<()> {
   // Кто подключился? uid и pid сообщает ядро — подделать их нельзя
   if s.peer_cred()?.uid() != expected_uid { return Err(io_err("чужой uid")); }

   loop {
      match recv_msg(&mut s).await? {
         Msg::Event { event_id, .. } => {
            let (ack_tx, ack_rx) = oneshot::channel();
            // send().await: при перегрузке ждём (backpressure), а не теряем событие
            store_tx.send((event_id, ack_tx)).await.map_err(io_err)?;
            ack_rx.await.map_err(io_err)?;                    // запись на диск завершена
            send_msg(&mut s, &Msg::Ack { event_id }).await?;  // Ack — только после записи
         }
         Msg::SegmentFd { seq, len } => {
            let fd = recv_fd(&s).await?;        // дескриптор приходит следом (SCM_RIGHTS)
            let seg = unsafe { File::from_raw_fd(fd) };
            let mut head = [0u8; 8];
            seg.read_at(&mut head, 0)?;         // read_at: offset у fd общий с отправителем
         }
         _ => {}
      }
   }
}
Что здесь важно:
- Ack после записи. Отправитель считает событие доставленным только после
Ack. Если приёмник упал, отправитель переподключается и шлёт событие снова; дубликаты снимаетevent_id. - Лимит размера сообщения. Пир недоверенный и не должен иметь возможности «заказать» гигабайт.
- Читать ровно столько байт, сколько заявлено. Иначе можно залезть в соседний пакет вместе с прикреплённым дескриптором.
read_at, а неread. Позиция чтения у переданного дескриптора общая с отправителем, позиционное чтение от этого не зависит.
4. Observability и безопасный OTA-конвейер
В скелете (v0): готовый OTA-инструмент (RAUC / SWUpdate / Mender) с A/B + dm-verity + watchdog и принудительным тестом отката; push логов и метрик через Vector с ограниченным буфером; исходящий туннель диагностики по запросу.
Позже: canary-раскатка, delta-обновления, включение anti-rollback, агрегированные гистограммы.
Edge-узел обязан быть прозрачным для мониторинга, но сам мониторинг не должен становиться причиной аварии.
Локальный демон Vector Daemon перехватывает структурированные логи и метрики через Unix Domain Socket. Телеметрия сжимается по алгоритму Zstd (для структурированных логов типичный коэффициент сжатия — порядка 8–12:1, но он зависит от данных и должен измеряться на реальном потоке) и пачками передается в защищенное облачное хранилище (Quickwit / S3) только при наличии стабильного соединения.
Вариант с упрощением. Если парк небольшой, Vector можно не ставить, а отправлять телеметрию тем же MQTT-брокером. Тогда стоит учесть три вещи: отдельное MQTT-соединение (или хотя бы чанки до ~16 КБ), чтобы большая пачка телеметрии не задерживала алерты в том же TCP-канале; ограничение скорости и джиттер при сливе накопленного буфера после восстановления связи; и отправку по умолчанию только метрик, структурных событий и ошибок, а полных логов — по запросу через диагностический туннель. Отправку полезно спрятать за trait
TelemetrySink, чтобы транспорт можно было сменить. В базовом дизайне мы оставляем Vector: он берёт на себя дисковый буфер, пакетирование и повторные попытки.
Слой Observability подчиняется тем же жестким лимитам памяти: кольцевой буфер телеметрии на диске имеет фиксированную квоту (например, 256 МБ). При переполнении старые логи ротируются, предотвращая деградацию основного сервиса записи видео.
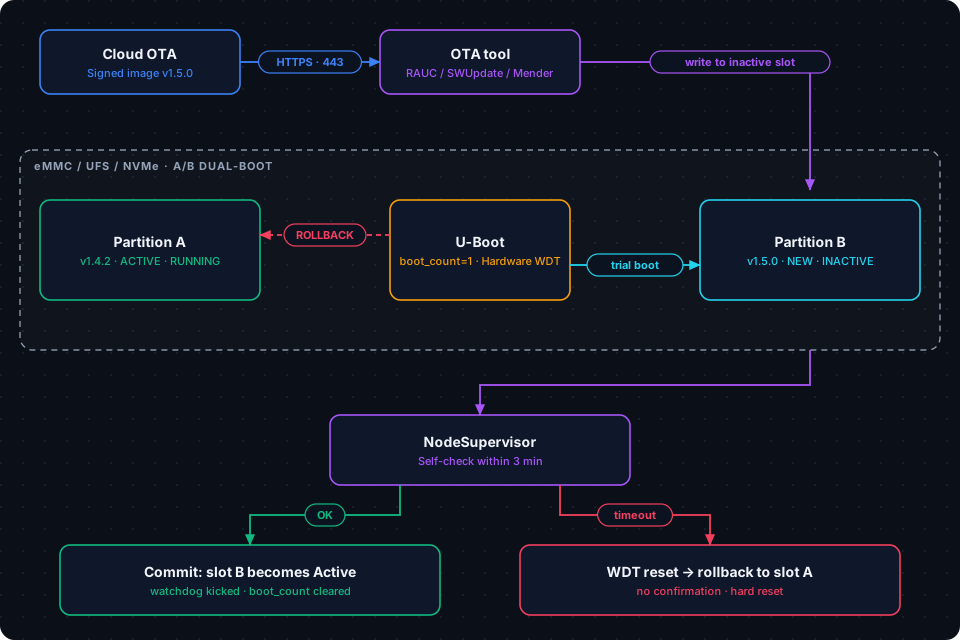
За доставку обновлений отвечает готовый OTA-инструмент (RAUC, SWUpdate или Mender). Писать свой установщик не стоит: A/B-слоты, интеграция с загрузчиком, проверка подписи и потоковая установка там уже отлажены, а лишняя самописная привилегированная и сетевая часть — это новая поверхность атаки. OtaManager в node-core остаётся тонкой логикой: берёт из подписанного Desired State ссылку и хеш образа, решает, когда ставить обновление (окно обслуживания, здоровье узла), запускает инструмент и подтверждает слот по итогам самодиагностики.
- A/B Dual-Boot разметка диска: Корневая файловая система разделена на два изолированных системных слота (
Partition AиPartition B). - Атомарная запись: Образ с криптографической подписью скачивается и проверяется инструментом до записи, затем записывается в неактивный слот.
- Hardware Watchdog и Auto-Rollback: Загрузчик (U-Boot) выставляет флаг пробного запуска
boot_count=1и передаёт управление новой системе. Если в течение 3 минут после стартаNodeSupervisorне подтвердил успешную самодиагностику и не сбросил таймер аппаратного сторожевого таймера (Hardware Watchdog), происходит жесткий аппаратный перезапуск с автоматическим откатом на предыдущую проверенную версию прошивки.
Архитектура в деталях: сквозной Data Flow
В скелете (v0): один сквозной сценарий: камера → событие (детектор-заглушка) →
event_queue→ облако →PUBACK, плюс одно жёстко заданное правило → GPIO-реле без облака.Позже: реальные модели, несколько потоков, вложенное шифрование архива с Client KEK.
Проследим пошагово, что происходит в системе от момента появления объекта в кадре до доставки уведомления на мобильное устройство клиента:
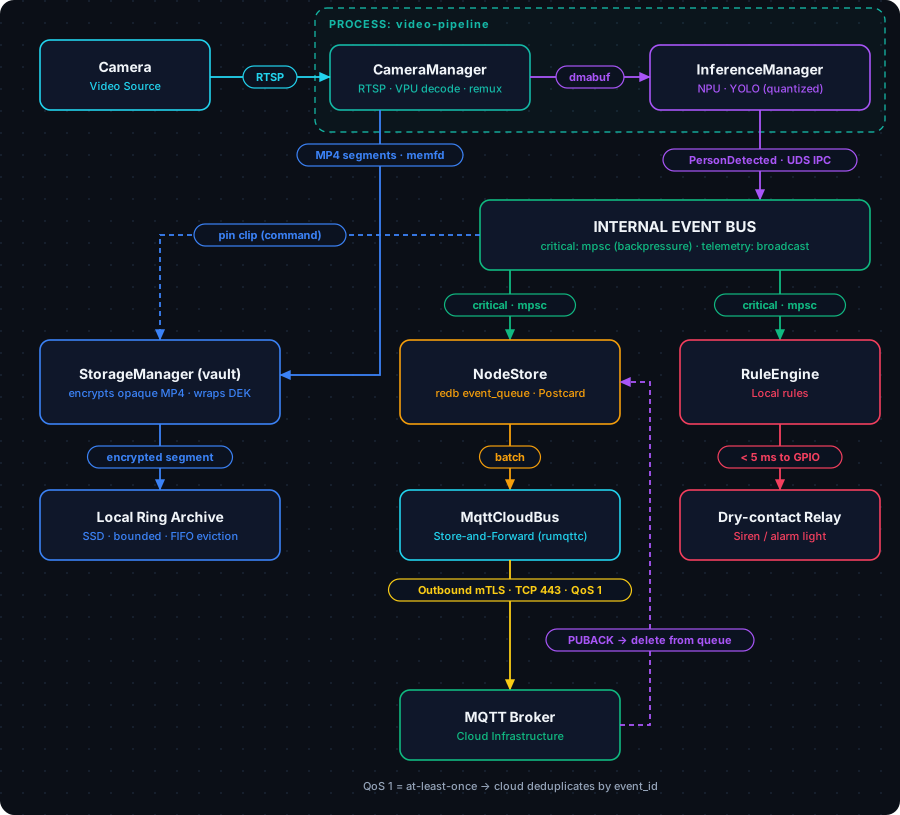
- Захват и Zero-Copy передача: Камера транслирует видео по RTSP. Процесс
video-pipelineпринимает пакеты и разбирает поток; дальше путь раздваивается: сжатые пакеты H.264/H.265 ремуксятся в 10-секундные MP4-сегменты без декодирования и уходят вvaultкак непрозрачные байты (memfdпоSCM_RIGHTS), а декодированные VPU кадры остаются внутри процесса и передаются в инференс хэндлом dmabuf без копирования. - Инференс на NPU: Нейроускоритель выполняет квантованную модель детекции (YOLO) и возвращает вектор координат (Bounding Boxes).
- Публикация в шину:
InferenceManagerформирует событиеPersonDetected { event_id, confidence: 0.94, bbox: [...] }и по IPC отправляет его вInternal Event Busпроцессаnode-core; уникальныйevent_idприсваивается на источнике. - Параллельная автономная обработка (критический путь идёт по собственным ограниченным каналам и не теряется):
RuleEngineсверяет событие с локальной базойrules. Обнаружив пересечение охраняемой зоны в нерабочее время, он подаёт сигнал на физическое реле (сухой контакт) тревожного прожектора или сирены. От получения событияRuleEngine’ом до сигнала на GPIO проходит менее 5 мс, полностью автономно от облака. Полная задержка от появления человека в кадре складывается из декодирования, инференса на NPU (обычно десятки миллисекунд) и этих 5 мс.StorageManager(процессvault) по команде «закрепить клип» отnode-coreзащищает текущий и соседние 10-секундные сегменты от кольцевой ротации. Каждый сегмент шифруется своим DEK, который вложенно запечатывается ключами Node KEK (Secure Element) и Client KEK (схема двух конвертов), и записывается в кольцевой архив. Содержимое сегментаvaultне разбирает.
- Гарантированная доставка (Store-and-Forward):
- Событие сериализуется в версионируемый формат Postcard и атомарно записывается в таблицу
event_queueбазыredb. - Модуль
MqttCloudBusвычитывает накопленный батч событий и передаёт его по исходящему mTLS-туннелю в облачный брокер EMQX. - Записи удаляются из
event_queueтолько после подтверждения MQTT QoS 1 (PUBACK). Если в момент отправки связь прервалась, события сохраняются в целостности до восстановления канала. - QoS 1 даёт семантику at-least-once, поэтому возможны дубликаты: у каждого события есть уникальный
event_id, и облако его дедуплицирует. Кроме того,PUBACKозначает «брокер принял», а не «событие обработано», поэтому подтверждение обработки в облаке строится отдельно.
- Событие сериализуется в версионируемый формат Postcard и атомарно записывается в таблицу
Чего пока не хватает: открытые вопросы целевой архитектуры
Честный список мест, которые описание выше не закрывает или закрывает лишь частично. Для каждого пункта указано, что делаем в скелете, а что позже.
1. Подпись и версионирование Desired State
Проблема. В том виде, как описано выше, тот, кто получил контроль над MQTT-брокером или облачным бэкендом, управляет всем парком. Закрытые порты и mTLS защищают канал, но не сам документ.
Решение.
- Desired State — подписанный документ: строго монотонный
generation, срок годностиnot_after(защита от replay старой конфигурации), подпись ключом, который хранится отдельно от брокера (KMS/HSM с аудитом) и ему недоступен. Открытый ключ закреплён (pinned) в образе и/или Secure Element. - Нода сохраняет last-known-good: если новая конфигурация не применилась или менеджер не вышел в
Readyза заданное время, она возвращается к предыдущей. - Нода отправляет обратно статус —
observed_generationи состояние каждого менеджера, — так облако видит расхождение (drift), а не слепо отправляет команды.
// Упрощённый концепт: подписанная конфигурация и статус ноды
pub struct SignedDesiredState {
   pub generation: u64,      // строго монотонный номер версии
   pub not_after: UnixTime,  // срок годности: защита от replay старых конфигураций
   pub payload: NodeDesiredState,
   pub signature: Signature, // ключ, недоступный облачному брокеру
}

pub struct NodeStatus {
   pub observed_generation: u64,      // какую версию нода реально применила
   pub last_known_good: u64,          // к какой версии можно откатиться
   pub managers: Vec<ManagerStatus>,  // Ready / Degraded / Failed + причина
}
Скелет: подпись, generation, статус, last-known-good. Позже: ротация подписывающих ключей, согласование изменений двумя операторами (two-person approval).
2. Anti-rollback против автоматического отката
Конфликт. Защита от отката (монотонный счётчик версий не даёт установить старую уязвимую прошивку) противоречит A/B-откату, который как раз загружает предыдущую версию.
Разрешение. Счётчик увеличивается только после commit — успешной самодиагностики новой прошивки. Образ несёт не только версию, но и security epoch, который повышается лишь в релизах с исправлениями безопасности. Сам счётчик хранится там, где его нельзя откатить: RPMB, NV-счётчик TPM, монотонный счётчик Secure Element. eFuse подходят плохо: число битов ограничено.
| Ситуация | Откат разрешён? | Механизм |
|---|---|---|
| Новая прошивка не прошла самодиагностику | Да, на предыдущий слот | Счётчик ещё не увеличен |
| Новая прошивка подтверждена (commit) | Нет — на версии ниже текущего epoch | Монотонный счётчик в RPMB / TPM NV / Secure Element |
| Обычный релиз без исправлений безопасности | Да, внутри одного security epoch | Образ несёт security_epoch, а не только номер версии |
Скелет: дизайн и формат метаданных образа. Позже: включение enforcement, когда налажен процесс выпуска релизов.
3. Миграция схемы БД и откат
Откат прошивки возвращает старый код, но не старые данные. Если новая версия мигрировала схему redb, старая версия не прочитает файл.
- Expand/contract. Новая версия читает и старую, и новую схему, но до commit пишет только в формате, понятном предыдущей версии. Необратимые миграции (contract) выполняются в следующем релизе, когда откат на старую версию уже невозможен.
- Копия перед миграцией. Перед любой миграцией на разделе данных создаётся копия файла БД (
db.pre-migration); она хранится до подтверждения следующего релиза. - Явные версии. Версия схемы записывается в БД и в каждую запись (версионируемый enum Postcard); старт с неизвестной версией — явная ошибка, а не молчаливое чтение.
- Тест. Потеря питания посреди миграции — отдельный сценарий fault injection.
Скелет: версии схемы и тест отката с миграцией. Позже: сами сложные миграции — по мере появления.
4. Read-only rootfs (dm-verity) и разделы данных
Secure Boot проверяет ядро, но без неизменяемой rootfs подменённая система (или повреждённая запись в неё) остаётся незамеченной.
| Раздел | Назначение | Режим |
|---|---|---|
boot | Загрузчик, ядро, dtb | Подписан, только чтение |
rootfs-A / rootfs-B | Системные слоты A/B | Read-only, dm-verity (корневой хеш подписан в цепочке загрузки) |
data | redb, конфигурация, логи | Чтение и запись, квота, зарезервированное место под БД |
archive | Видеоархив (кольцо) | Чтение и запись, собственная квота |
tmpfs | Временные файлы | В RAM, не переживает перезагрузку |
Архив и данные — разные разделы: переполнение видеоархива не должно отнять место у redb. Это прямое продолжение принципа Bounded by Design.
Скелет: вся раскладка целиком, потому что она необратима.
5. Staged-раскатка и стоимость LTE-трафика
- Кольца. Сначала лаборатория и внутренние устройства, затем 1%, 10% и 100% парка. Переход между кольцами — по health-gates из телеметрии (частота крашей и перезагрузок, p99.9 кадра, доля успешных commit); при деградации раскатка автоматически ставится на паузу.
- Трафик. Иллюстративный расчёт: образ 300 МБ × 1000 узлов = 300 ГБ. Delta-обновление размером 5–10% от образа снижает это до 15–30 ГБ. Нужны возобновляемая загрузка, ограничение полосы, окна загрузки (например, ночью) и месячный бюджет трафика на узел.
- Подпись. Подпись образа проверяется до записи в неактивный слот, а не после.
Скелет: полный образ, проверка подписи, возобновляемая загрузка. Позже: кольца и delta-обновления.
6. Диагностика при закрытых портах
Узел без входящих соединений нужно уметь обслуживать, иначе первый же полевой инцидент закончится выездом инженера.
- Сессия по запросу. Оператор создаёт запрос в облаке (с тикетом и сроком); в подписанный Desired State попадает запись
diagnostics { until, scope, ticket }; нода сама открывает исходящий mTLS-туннель на bastion-хост. Постоянно слушающего порта по-прежнему нет. - Наименьшие привилегии. По умолчанию доступ только на чтение (логи, метрики, состояние менеджеров). Интерактивный shell — только с короткоживущим сертификатом SSH CA и после согласования. Все сессии пишутся в аудит.
- Ограничение жизни. Сессия закрывается по таймеру и не переживает перезагрузку.
Скелет: минимальный вариант только на чтение. Позже: интерактивный shell.
7. Тесты потери питания: статистика и стенд
Один прогон ничего не доказывает.
- Стенд. Аппаратный (hardware-in-the-loop): программируемый источник питания или реле, которые отключают питание в случайные моменты — во время
fsync, коммитаredb, записи OTA в неактивный слот, загрузки, миграции схемы. Кроме мгновенного отключения нужны брауны: медленное падение напряжения и «дребезг» питания. - Статистика. По «правилу трёх» серия из N циклов без единого отказа позволяет утверждать с 95% уверенностью лишь то, что вероятность отказа на цикл ниже примерно 3/N: для 1000 циклов — ниже 0,3%, для 10 000 — ниже 0,03%. Поэтому на релиз-кандидат нужны тысячи циклов.
- Инварианты после каждого цикла. БД открывается без ручных действий; ни одно неподтверждённое событие не потеряно (дубликаты допустимы — их снимает дедупликация по
event_id); индекс архива согласован с файлами; узел загрузился в корректный слот. - Разделение конвейера. Программные сбои (
iptables,tc netem,stress-ng) гоняются на каждый коммит; аппаратные — по расписанию (ночью) и перед релизом: для обычного CI это слишком долго и дорого.
Скелет: стенд и серия циклов — это и есть главное доказательство скелета.
Заключение
Архитектура, описанная в этой статье, — это конвергенция проверенных временем фундаментальных инженерных принципов и современных системных практик. Это целевая архитектура нашей Edge-платформы, а «Ходячий скелет» (Walking Skeleton) — её первый тонкий срез: ровно те решения, которые нельзя безболезненно переделать после выхода на объекты, плюс один сквозной сценарий, проверенный на хаосе.
Каркас этой архитектуры прочно держится на пяти инвариантах:
- Мы не доверяем среде (Zero Trust): закрытые входящие порты, аппаратная идентичность устройства (Secure Element / BootROM / TPM), сквозной Secure Boot и криптографическая проверка цепочки до
dm-verityкорневой файловой системы, изоляция менеджеров по процессам и вложенное шифрование видеоархива существенно снижают риск локального вмешательства и ограничивают радиус атаки (Blast Radius Control), не давая скомпрометировать софт. - Мы принимаем неизбежность сбоев (Resilience Engineering): декларативная реконсиляция, изолированные процессы и акторы, Crash-Safe хранилище
redbна подходящем промышленном накопителе и устойчивый к обрывам сети Store-and-Forward с идемпотентной доставкой. Мы строим систему по моделиCrash-Only Software, где штатный механизм восстановления — это сверхбыстрый и детерминированный автоматический рестарт. - Мы уважаем физические ограничения железа (Mechanical Sympathy): жёстко лимитированные очереди и кольцевые буферы данных (Bounded Resources), полностью исключающие неконтролируемые аллокации в куче и риски
OOM-killer. Проектирование от плоских структур данных (SoA) вместо графов объектов позволяет процессору максимально эффективно использовать кэш-линии и удерживать p99.9 латентности в рамках строгого кадрового бюджета. - Мы проектируем софт под физическую топологию кремния (Hardware-Software Co-Design): отказ от слепых слоёв абстракции ради максимального FPS на ватт. Математика алгоритмов подчиняется логике транзисторов через жесткое квантование в INT8 под инструкции векторных и матричных ускорителей, а конвейер передачи данных работает по принципу Zero-copy (
VA-API,dmabuf,Remote Tensors / IOBinding), исключая паразитный трафик по общей шине Unified Memory. - Мы измеряем состояние, а не декларируем его (Observability): нелинейная природа сбоев асинхронного рантайма Rust (
tokio) и инференс-движков (OpenVINO / ONNX Runtime) контролируется сквозным контекстом (Trace Context). Локальный ограниченный в ресурсах OTel-агент и механизм триггерного контекстного семплирования позволяют размотать причинно-следственные связи аномалий на лету, не создавая оверхеда на горячем пути видеопотока.
Построив такой сквозной, отказоустойчивый и аппаратно-эффективный каркас, мы получаем систему с измеримым запасом прочности. Поверх этого фундамента можно уверенно наращивать любую прикладную функциональность — от распознавания лиц и номеров до сложной распределённой трекинговой аналитики, — зная, что система сохранит целостность в любых условиях реального физического мира.